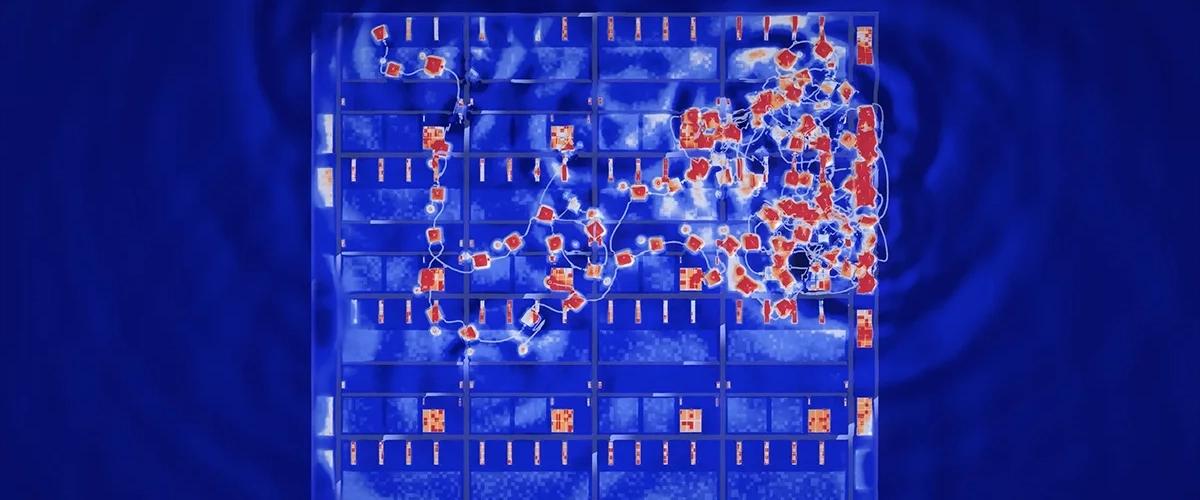
Концепция «взаимодействующих сетей» (interaction nets) состоит в том, что программа описывается как граф узлов, а вычисления происходят через локальные переписывания связанных узлов. Особенность такого подхода в том, что каждое вычисление затрагивает лишь небольшую часть графа, каждая зависимость явно указана, и у каждого значения ровно один владелец. Благодаря этому отпадает необходимость в сложных механизмах предсказания зависимостей, блокировках и когерентности кэшей, которые сегодня съедают значительную часть площади и энергии процессора.
Набор из 25 тестовых задач, 15 из которых держались в секрете до финальной проверки, показал впечатляющий результат: производительность на ватт в 4,59 раза выше, чем у современного серийного суперскалярного ядра (двухвходового, с последовательным исполнением).
При этом важнее другое — весь путь от концепции до финальной топологии чипа создали автономные ИИ-системы. Они самостоятельно перебирали варианты компилятора, архитектуры набора инструкций, микроархитектуры, RTL-описания и верификации, а в найденных решениях обнаружились неожиданные аппаратные примитивы, до которых человеку было бы трудно додуматься.
Чтобы сделать такой процесс управляемым, исследователи Architect Labs создали собственный формальный язык спецификаций ASL, который транслируется в проверяемую математическую модель на языке Lean. Именно формальный контракт, а не текстовый документ, стал единым источником истины для всей команды ИИ-агентов: любое изменение в архитектуре проверялось на соответствие спецификации, моделировалось, реализовывалось в RTL и оценивалось по энергопотреблению. Такой подход позволил всего за несколько итераций добиться согласованности модели и реальной схемы с точностью до 5% и избежать целого класса ошибок, типичных для «человеческого» проектирования.
Особый интерес вызывает рожденная в процессе эмерджентная особенность — «кража работы». Поскольку параллелизм в сетях взаимодействий распределен в пространстве, центральный планировщик не нужен. Каждый вычислительный блок сначала выполняет свою работу, затем забирает задачи у соседей, у которых их избыток, а если работы нет нигде — просто засыпает для экономии энергии. Эта элегантная схема не была прописана людьми: ИИ-агенты вывели ее самостоятельно, шаг за шагом оптимизируя метрики производительности на конкретных регрессионных тестах.
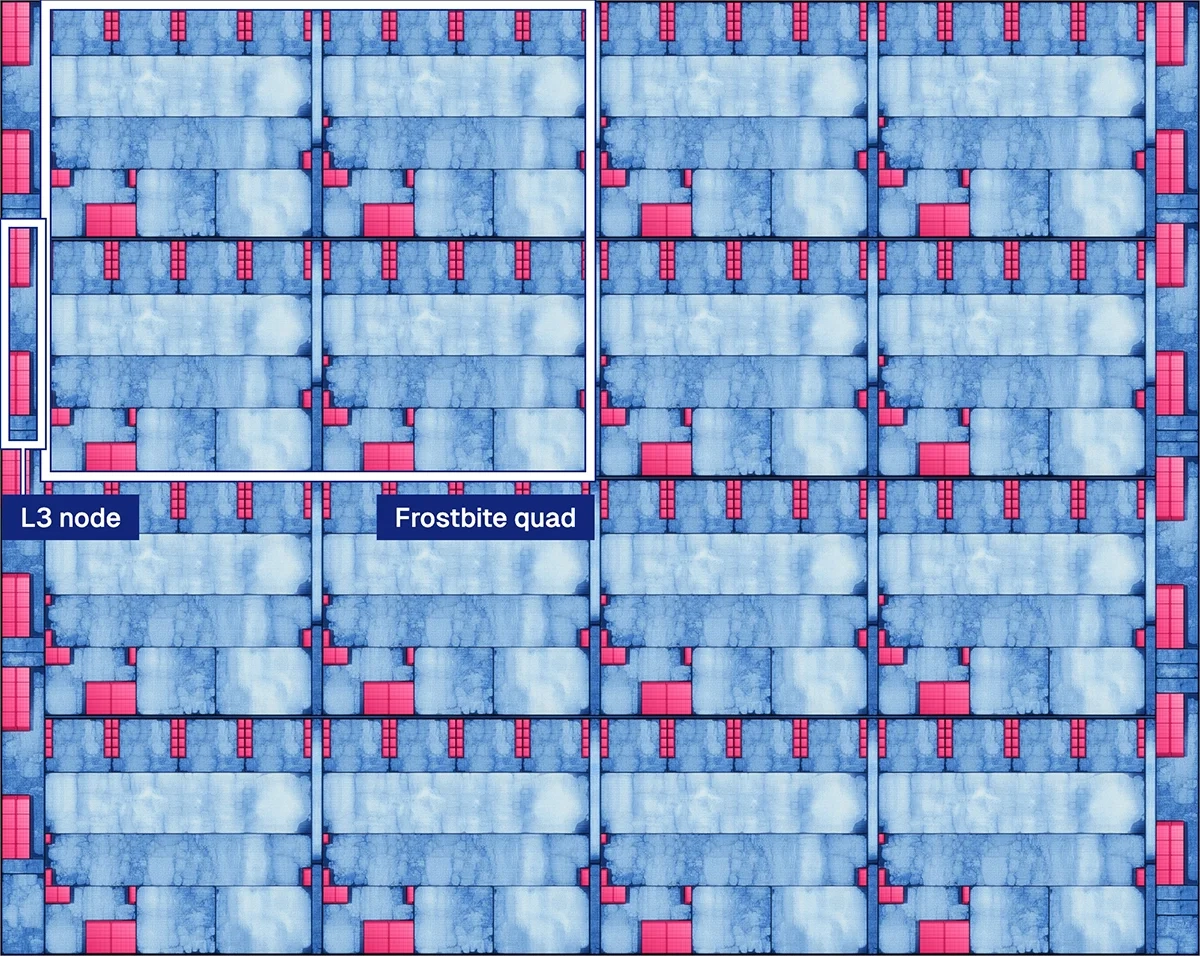
Результаты синтеза на 7-нм техпроцессе: квад (сетка 2×2 из вычислительных плиток) вместе с четырьмя узлами L3 занимает 0,792 мм² и работает на частоте 800 МГц при синтезе и 500 МГц в финальной топологии. Для сравнения, современное суперскалярное ядро на том же техпроцессе занимает 0,895 мм².
Энергетический профиль Frostbite показывает, где кроется выигрыш: если традиционное ядро тратит 57% энергии на память и 27% на выборку и декодирование инструкций, то Frostbite снижает эти показатели до 38% и 6% соответственно, зато 26% энергии уходит на внутрикристальную сеть и планировщик.
При масштабировании на массив 4×4 энергопрофиль почти не меняется — в отличие от многоядерных CPU, где рост числа ядер требует все более тяжелых механизмов когерентности кэшей.
«Мы убеждены, что по мере совершенствования систем ИИ все известные сегодня типы микросхем — от серверных процессоров и ускорителей для задач ИИ до сетевых коммутаторов и сетевых адаптеров — пройдут через подобные фундаментальные архитектурные трансформации», — говорится в пресс-релизе.
В ближайшие месяцы команда обещает сравнить сетчатые конфигурации Frostbite с многопроцессорными системами на крупных отраслевых бенчмарках вроде SPEC и PARSEC.
Huawei сократила технологическое отставание от Apple в производстве мобильных процессоров с четырех до трех лет благодаря архитектурным решениям. Как отмечают аналитики Bernstein, новый чипсет Kirin 9050 Pro обогнал 3-нанометровый Apple A17 Pro в многоядерном тесте Geekbench 6.


