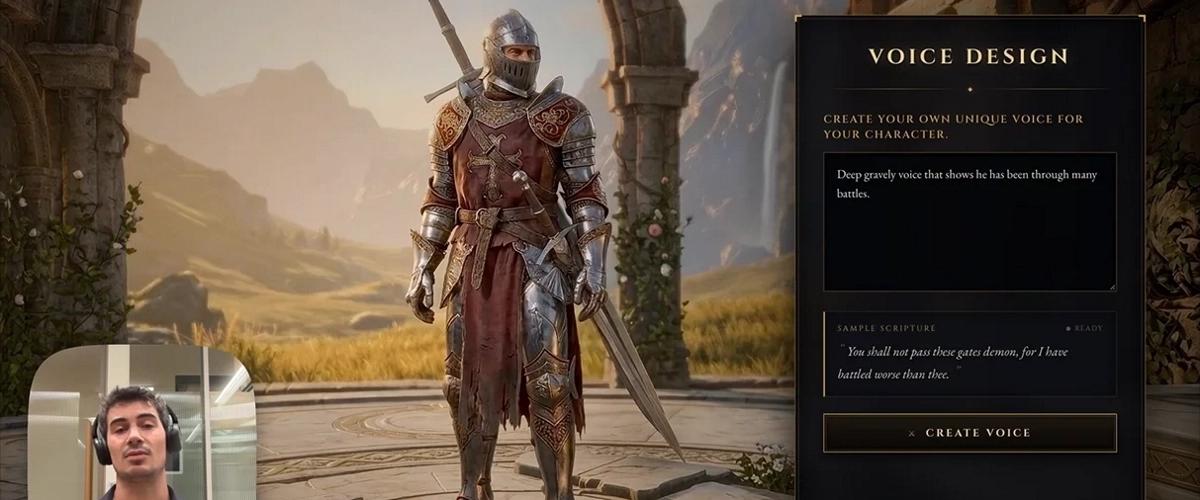
Gemini 3.8 Flash TTS позволяет создавать голоса с нуля. Пользователь может описать на естественном языке нужный голос, его роль, акцент и особенности речи, например, задать голос персонажа или региональную манеру произношения. Модель поддерживает более 100 языков и диалектов. Кроме того, Google предлагает библиотеку из более чем 2 тыс. готовых голосов, включая варианты английского, французского и испанского. Компания также планирует добавить возможность тонко настраивать готовые голоса — менять тембр, высоту тона, скорость речи и акцент.
Модель также умеет воспроизводить голос конкретного человека. Для этого достаточно 30-секундной аудиозаписи самого пользователя или человека, который дал разрешение на использование голоса. Google заявляет, что перед созданием копии система проверяет наличие согласия, а весь сгенерированный звук маркируется незаметным водяным знаком SynthID.
Еще одно отличие новых моделей — управление исполнением на уровне отдельных реплик. В сценарий можно добавлять инструкции о том, как должна звучать фраза: задавать эмоциональное состояние, темп или манеру речи, а также добавлять невербальные реакции вроде смеха и вздохов. Модели способны создавать диалоги с двумя говорящими и сохранять характеристики голоса на протяжении длинных записей. Это пригодится для подкастов и аудиокниг.
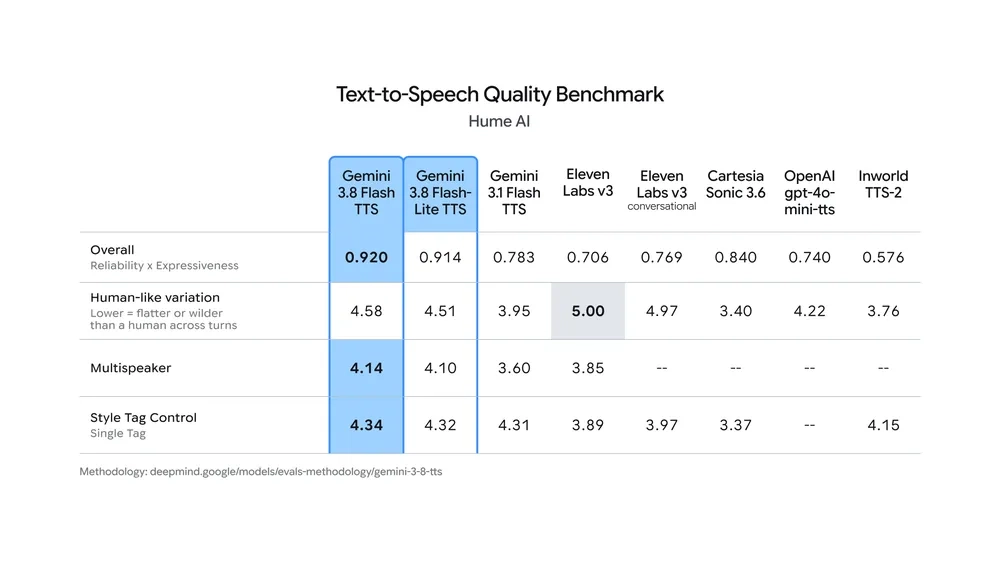
Gemini 3.8 Flash-Lite TTS предназначена для задач, где важны скорость и стоимость генерации. Google предлагает использовать эту модель для дубляжа, создания аудиоконтента и голосовых ИИ-агентов. При этом модель также позволяет управлять тоном, темпом и другими характеристиками речи.
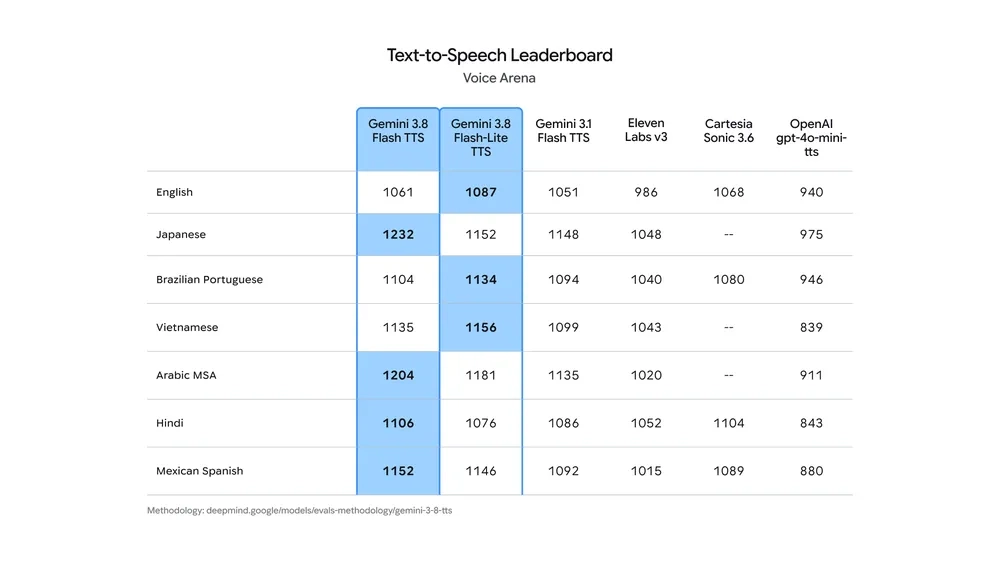
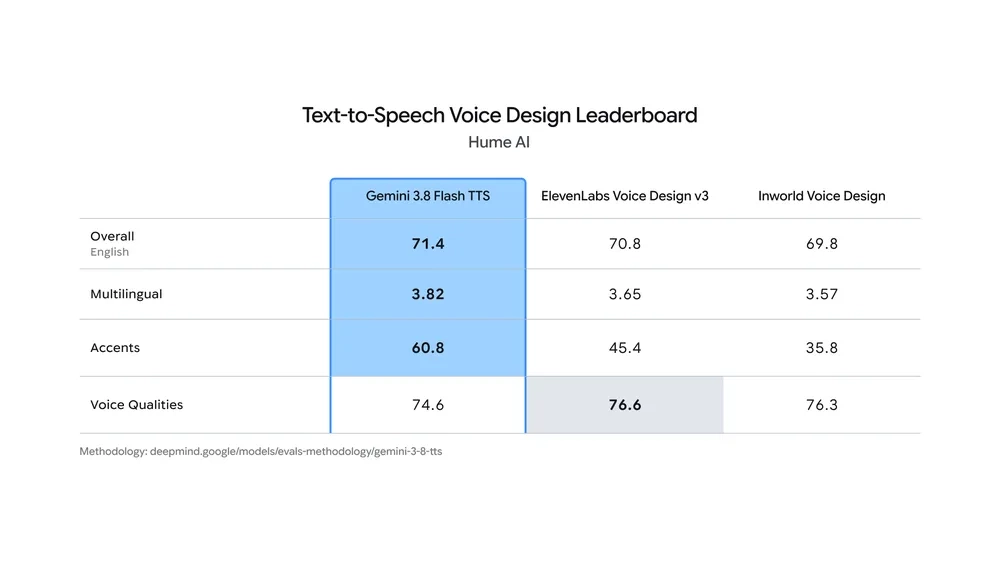
По данным Google, Gemini 3.8 Flash TTS получила 71,4 балла в Hume AI Voice Design Benchmark и показала лучший результат в категории моделирования акцента — 60,8 балла. Компания также заявляет, что обе новые модели заняли ведущие позиции в слепом пользовательском тестировании Voice Arena на нескольких языках, включая японский, бразильский португальский, вьетнамский, арабский, мексиканский испанский и хинди.
Gemini 3.8 Flash TTS начинает распространяться через Gemini API и Google AI Studio, а позднее станет доступна предприятиям через Gemini Enterprise. Flash-Lite также запускается в API и Google AI Studio и будет использоваться в Google Vids. В AI Studio разработчики могут создавать собственные голоса и сразу применять их в сценариях с несколькими говорящими.


