Нейробиологи годами работают над способами использования функциональной магнитно-резонансной томографии (фМРТ) для реконструкции того, что люди видят и что происходит в их сознании. Первые попытки давали размытые и трудноразличимые изображения. Однако постепенно прогресс в технологиях — как в самой томографии, так и в инструментах интерпретации результатов — привел к улучшениям.
Магнитно-резонансный томограф отслеживает поток насыщенной кислородом крови через мозг; области, которые «загораются» на сканах, считаются особенно активными в данный момент. Результаты не особенно точны: обычно подсвеченный «воксель» активности охватывал около трех кубических миллиметров, а каждый кубический миллиметр содержит около 16 000 нейронов. Но ученые из Института Вейцмана использовали более новые наборы данных, собранные сканерами с более высоким разрешением, где в каждом вокселе было около 1 мм³ нейронов.
Исследователи хотели точнее воссоздавать увиденные изображения. В первую очередь, они обучили модель-декодер на сканах восьми человек, которым, пока они были в аппарате фМРТ, показали около 9000 изображений.
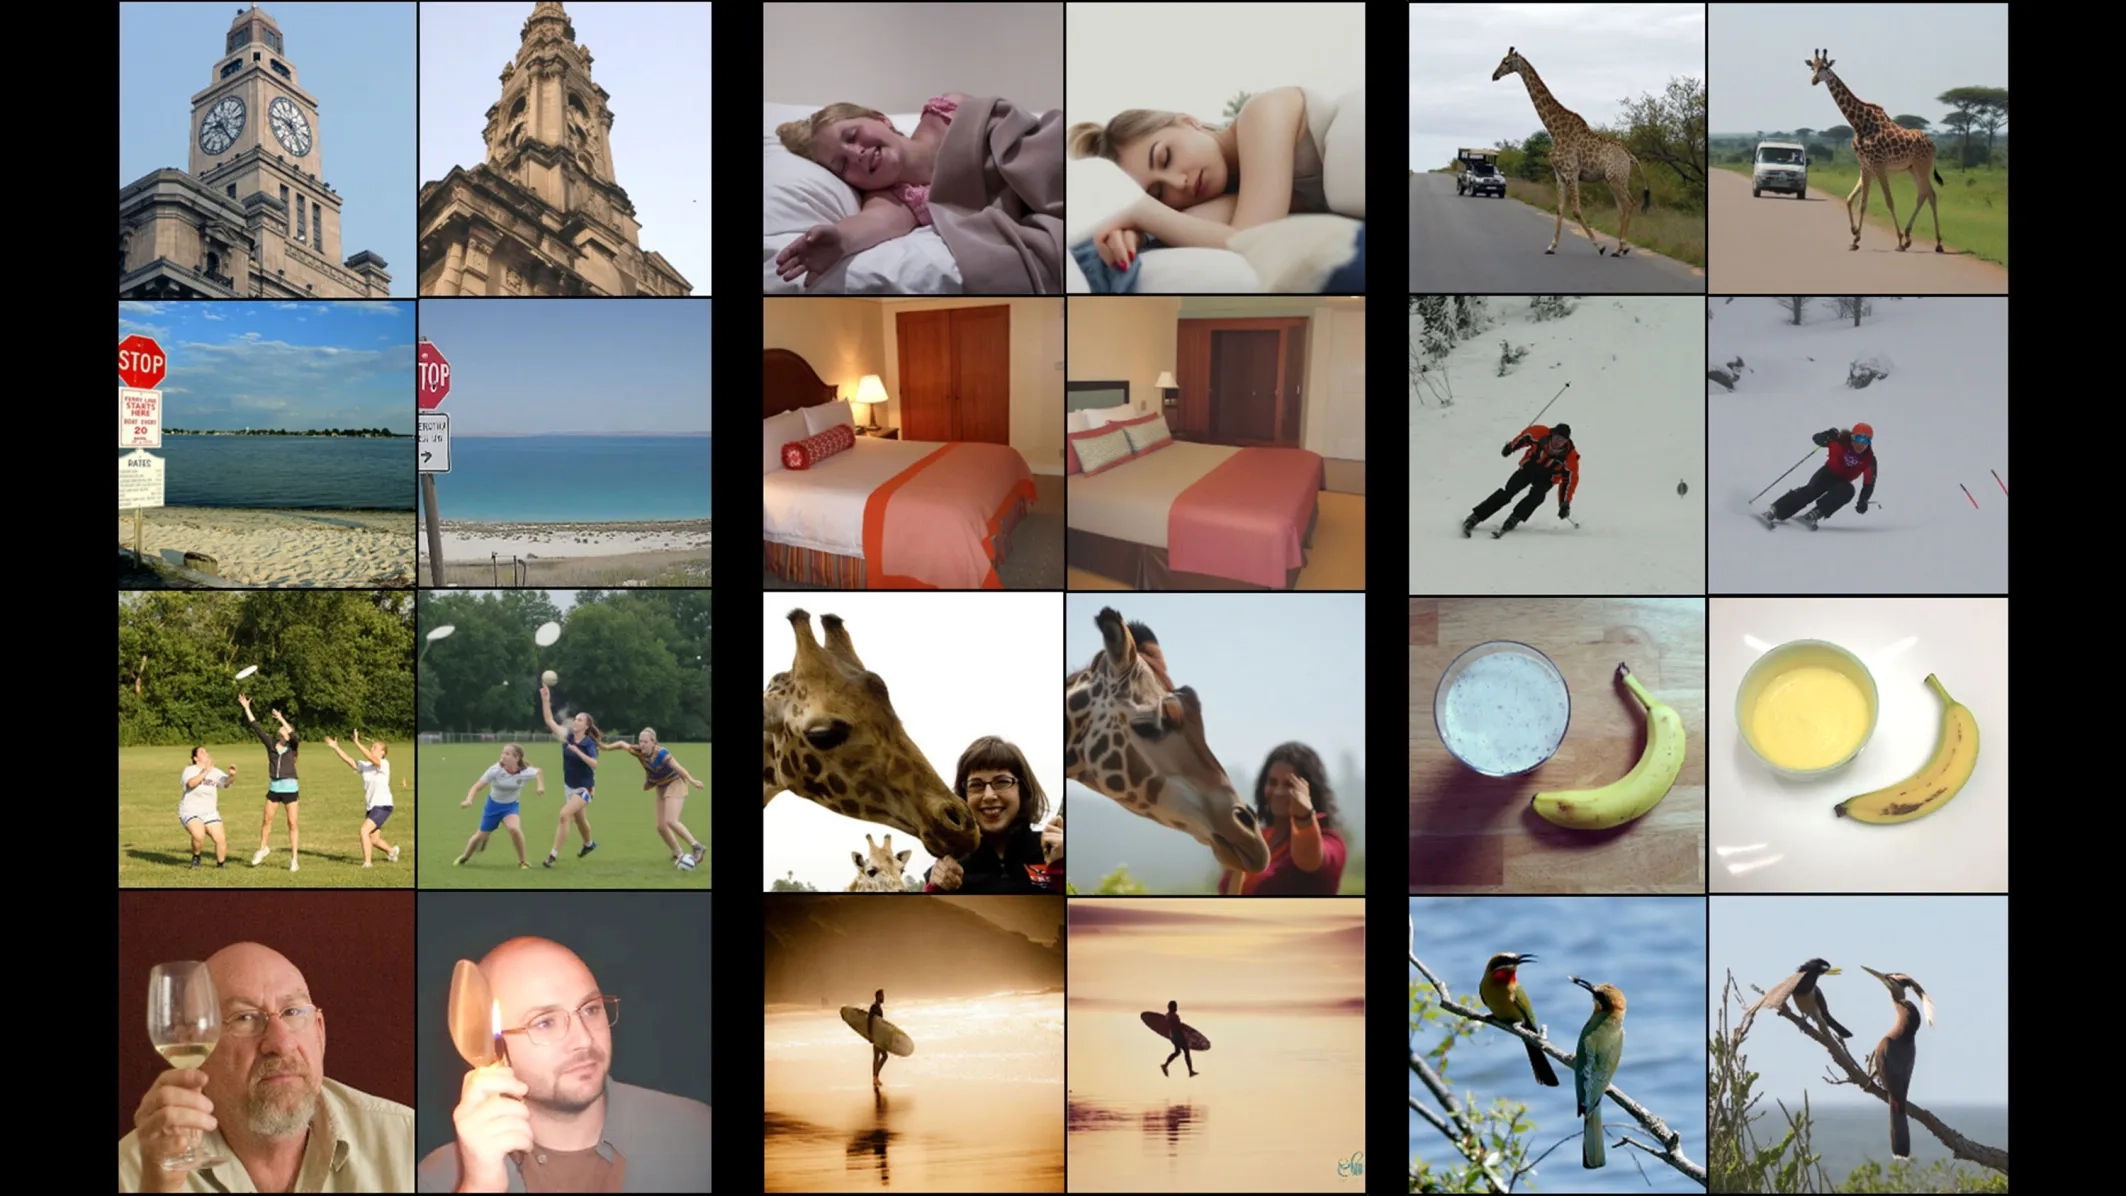
Левое изображение в парных картинках человек видел на самом деле. Правое сгенерировано ИИ на основе данных фМРТ.
Однако этих данных было мало, поэтому ученые обучили еще одну модель — энкодер, предсказывающий активность мозга по изображению, — и использовала энкодер и декодер вместе для улучшения обоих инструментов. Работает это так: берем новое изображение, скажем, леопарда, используем энкодер, чтобы предсказать, как выглядел бы скан фМРТ человека, увидевшего эту картинку, затем декодер реконструирует изображение. Сначала реконструкция вряд ли будет похожа на леопарда, но повторное обучение моделей таким образом в конце концов приводит к значительным улучшениям. Этот подход также позволяет обучать модели на сколь угодно большом числе изображений, которые даже никогда не показывали человеку в аппарате фМРТ.
Объединив данные из нескольких исследований, команда смогла выявить области мозга, которые, по-видимому, выполняют общие функции у всех людей: одна область реагировала на изображения еды, другая — на изображения спорта.
Полученный «универсальный энкодер мозга» может работать со сканом нового человека при минимальной калибровке: если раньше инструменту обычно требовалось около 40 часов данных фМРТ о новом человеке, прежде чем начать предсказывать, что тот видит, то новому декодеру нужен всего час данных. Это существенно облегчает исследования мозга, учитывая, что стоимость работы с подобным аппаратом составляет 600–1000 долларов в час, пишет Technology Review.
В дальнейшем исследователи планируют перейти от изображений к видео и аудио, а затем и научиться реконструировать то, о чем люди думают, что воображают, что видят во сне.
В начале прошлого года стартап Based Hardware представил носимое устройство Omi с «мозговым интерфейсом». Гаджет предназначен для повышения продуктивности: устанавливает напоминания, резюмирует разговоры, переводит речь, поддерживает голосовые команды и даже, как говорят, читает мысли пользователя.


